claude.dev 工程博客《How the Claude Code team does code review》精读。目标改写:revert 与事故不升,人时最小;七层防线与风险分级审批;事故即 eval · 噪音度量 · 审查收敛;对照自身四道关与苹果支付验证链,分三批改进。
基于 claude.dev 工程博客文章《How the Claude Code team does code review》整理。学习时逐节对照了我自己的 agent 开发流程,讨论内容放在第 8 到 10 节。
0. 来源与关联
0.1 原始文章
| 项目 | 内容 |
|---|---|
| 标题 | How the Claude Code team does code review |
| 作者 | Addy Osmani、Morgan Westlee Lunt、Qing Wang |
| 发布时间 | 2026-10-15 |
| 发布位置 | claude.dev 博客,Engineering 栏目 |
| 原文链接 | https://claude.dev/blog/solving-code-review-at-anthropic/ |
| 原文 Markdown 版 | https://claude.dev/blog/solving-code-review-at-anthropic.md |
| 阅读时长 | 约 14 分钟 |
| 致谢的审稿人 | Emma Webb、Michael Segner、Amie Rotherham |
文章做了三件事:
- 重新定义代码审查的目标:不是"有人读过",而是在 revert 和事故不上升的前提下,尽量少花人的时间;
- 拆开 Claude Code 团队一个改动从作者机器到用户要经过的七层检查,以及他们怎么持续改进 AI reviewer;
- 说明人还保留哪些职责、代码没人逐行读之后团队怎么理解代码,最后给出一份落地清单。
0.2 文章中提到的工具
| 工具 | 是什么 | 文档 |
|---|---|---|
/code-review |
在本地跑的轻量版 AI 审查 | — |
| Code Review for Claude Code | 托管版 PR 审查,已在 Team / Enterprise 计划正式发布;管理员按仓库选 Quick / Standard / Deep 三档深度 | https://code.claude.com/docs/en/code-review |
/security-review 与开源的 security review GitHub Action |
自动安全审查,本地命令和 CI 两种用法 | https://support.claude.com/en/articles/11932705-automated-security-reviews-in-claude-code |
| Claude Code GitHub Action | 落地清单里给出的另一种接入 AI reviewer 的方式 | — |
容易误解的一点:文章说 Code Review 这个产品只发审查意见,不替人批准 PR。他们自己仓库里"低风险改动只靠自动检查就合入",是仓库 owner 自己定的规则,不是产品默认行为。
0.3 文章中引用的延伸阅读
- Anthropic 工程博客《Redesigning source control》:https://www.anthropic.com/engineering/redesigning-source-control (monorepo 每天合入 2,500 → 30,000+ 这组数字的出处)
- Claude Code 最佳实践:https://code.claude.com/docs/en/best-practices ("让 Claude 拿输出自证""用全新上下文的子 agent 审 diff"两个习惯的出处)
- Boris Cherny 关于"给 Claude 验证手段"的推文:https://x.com/bcherny/status/2007179861115511237
- Code Review 研究预览发布文章:https://claude.com/resources/articles/code-review
- 扩展 CI 的文章《Agentic coding is straining CI: here's how we scaled test impact analysis at Anthropic》:https://claude.com/resources/articles/agentic-coding-is-straining-ci-heres-how-we-scaled-test-impact-analysis-at-anthropic
- 文中"公开频道"链接到的 Claude Tag(Slack 里的 Claude):https://claude.com/product/tag
0.4 本笔记的阅读约定
- 【原文】 标注的内容来自文章,均为意译和归纳,不是原文摘录。
- 【解读】 标注的内容是学习过程中的理解、例子和推演,用于帮助吃透原文。
- 【批判性阅读】 标注的内容是用文章自己的标准反过来审视文章的结果,原文中没有。
- 第 1 到 7 节按原文顺序走;第 8 到 10 节是学习时对照我自己流程的讨论,"我"指笔记作者。
- 原文的 Fig A 到 Fig D 四张编号图和一张未编号的示意图已嵌入对应小节,图注标原文编号。图里的文字是英文,正文在图下给出读图方法和中英对照。配图从原文页抓取,托管在自有 CDN(2026-10-26)。
- ⚠️更正:初稿写的是"原文有五张图(Fig A 到 Fig E)"。2026-10-26 抓图时核对,现版原文只有 A 到 D 四张编号图,外加 6.2 节那张未编号的示意图;6.1 节原先引用的"Fig E"已删去。
1. 全文主线
核心矛盾:agent 写代码的产量远远超过人能读的量。Claude Code 约 90% 的代码由 Claude 写;Anthropic monorepo 每天合入的改动从 5 月的约 2,500 个涨到 9 月的 30,000 多个。逐行人工审查已经做不到,但不审又会出事。
全文一句话:在 revert 率和事故率不上升的前提下,最小化每个改动花掉的人的时间。
结果:6 月到 9 月,Claude Code 仓库合并的 PR 翻了一倍多,需要 revert 的 PR 占比下降了 40% 以上。
三招:
- 把大部分"读代码"交给机器,在人看之前设多层自动检查;
- 人的注意力按风险分配,改文档不用人,改计费要两个人;
- 重点投资"能快速撤销":开关、灰度、一键回滚。
全文结构:
重新定义审查(目标函数)
        ↓
七层防线:1 PR 前自证 → 2 AI 审查 → 3 安全审查 → 4 CI
          → 5 风险分级审批 → 6 merge queue / 开关 / 放量 → 7 发现与回滚
        ↓
让 reviewer 变好:事故即 eval / 衡量噪音 / 保证收敛
        ↓
人保留什么 · 团队怎么懂代码 · 文化(谁合入谁负责、方向不对早关)
        ↓
落地清单 · 方向
本笔记按"目标 → 七层 → reviewer 迭代 → 人与文化 → 落地 → 对照我的流程"的顺序组织。
2. 重新定义代码审查
2.1 审查的两个职能
【原文】代码审查一直在做两件事:一是在上线前发现并修掉问题;二是让团队建立对代码的共同理解。文章主要讲前者,后者放到结尾。
【解读】机器接手"读代码"以后,第二个职能会出现空缺,需要单独补(见 6.2)。
2.2 换一个问题问
【原文】"有没有人读过这段代码"只是一个不精确的代理指标。真正该问的是:这个改动可能出什么错?哪一种检查(自动的或人工的)最适合拦住它?
【解读】这样一问,"人逐行读"就从必选项变成了众多检查手段里的一种。类型错误交给类型检查,回归交给测试,两个 PR 合起来冲突交给 merge queue,"该不该做"才交给人。每类风险配一个最便宜又可靠的检查,后面所有设计都是从这个问题推出来的。
2.3 从闸门变成拼写检查
【原文】以前审查是流程末端的一道闸门:写完代码、开 PR、等同事审。现在审查在写代码的过程中一直在跑,像打字时的拼写检查。人被叫来之前,大多数改动已经被 Claude 审过、修过至少一轮,常规错误基本清掉了,人的注意力留给更高层的问题。
2.4 稀缺的是人的时间:目标函数怎么定
【原文】人的时间成本有两部分:花在审查上的时间,和花在修复坏代码造成的问题上的时间。只压低前者没有意义,时间会以返工的形式回来。
| 内容 | |
|---|---|
| 优化目标 | Claude Code 各仓库(CLI、桌面/Web、移动端)大部分 PR 最多只需要一个人参与,这个人可以是作者本人 |
| 人时间的度量 | 每个 PR 的人工审批数(中位数和 P95)、人工评论数、PR 等人处理的时长 |
| 护栏指标 | revert 率、事故率。它们一上升,就说明时间没省下来,只是挪了地方 |
【解读】这和 A/B 实验里"主指标 + 护栏指标"是同一个结构:主指标往一个方向优化,护栏保证没把别的东西搞坏。学习时我对"只看 PR 审批人数会怎样"的回答是:任何领域只盯一个指标都会出结构性问题;只看审批人数、不管上线后的 fix / revert(返工),总时间其实没变。这就是古德哈特定律:一个指标一旦被当成目标,就不再是好指标。评测爬山那篇讲的是同一件事,见自动化评测设计与爬山优化:学习笔记。
2.5 【批判性阅读】两个数字要细看
- revert 下降的是占比,不是绝对数。PR 数翻倍多、revert 占比降 40% 多,粗算 ,revert 的绝对次数可能还略有上升,只是增速远低于产量。结论依然成立(产量翻倍、质量没变差),但要清楚说的是哪个数。
- 文章定义了"人时间"的三个度量,却没有报告它们的前后变化。给出的结果是 PR 数和 revert 占比,按文章自己的目标函数,"人花的时间确实少了"这一半没有数据直接支撑。
3. 七层防线(上):合入之前
【原文】Fig A 画的是一个典型改动从作者机器(或 Slack 里的 Claude 会话)到用户的路径:大部分路径是自动的,人的注意力放在有风险的地方。
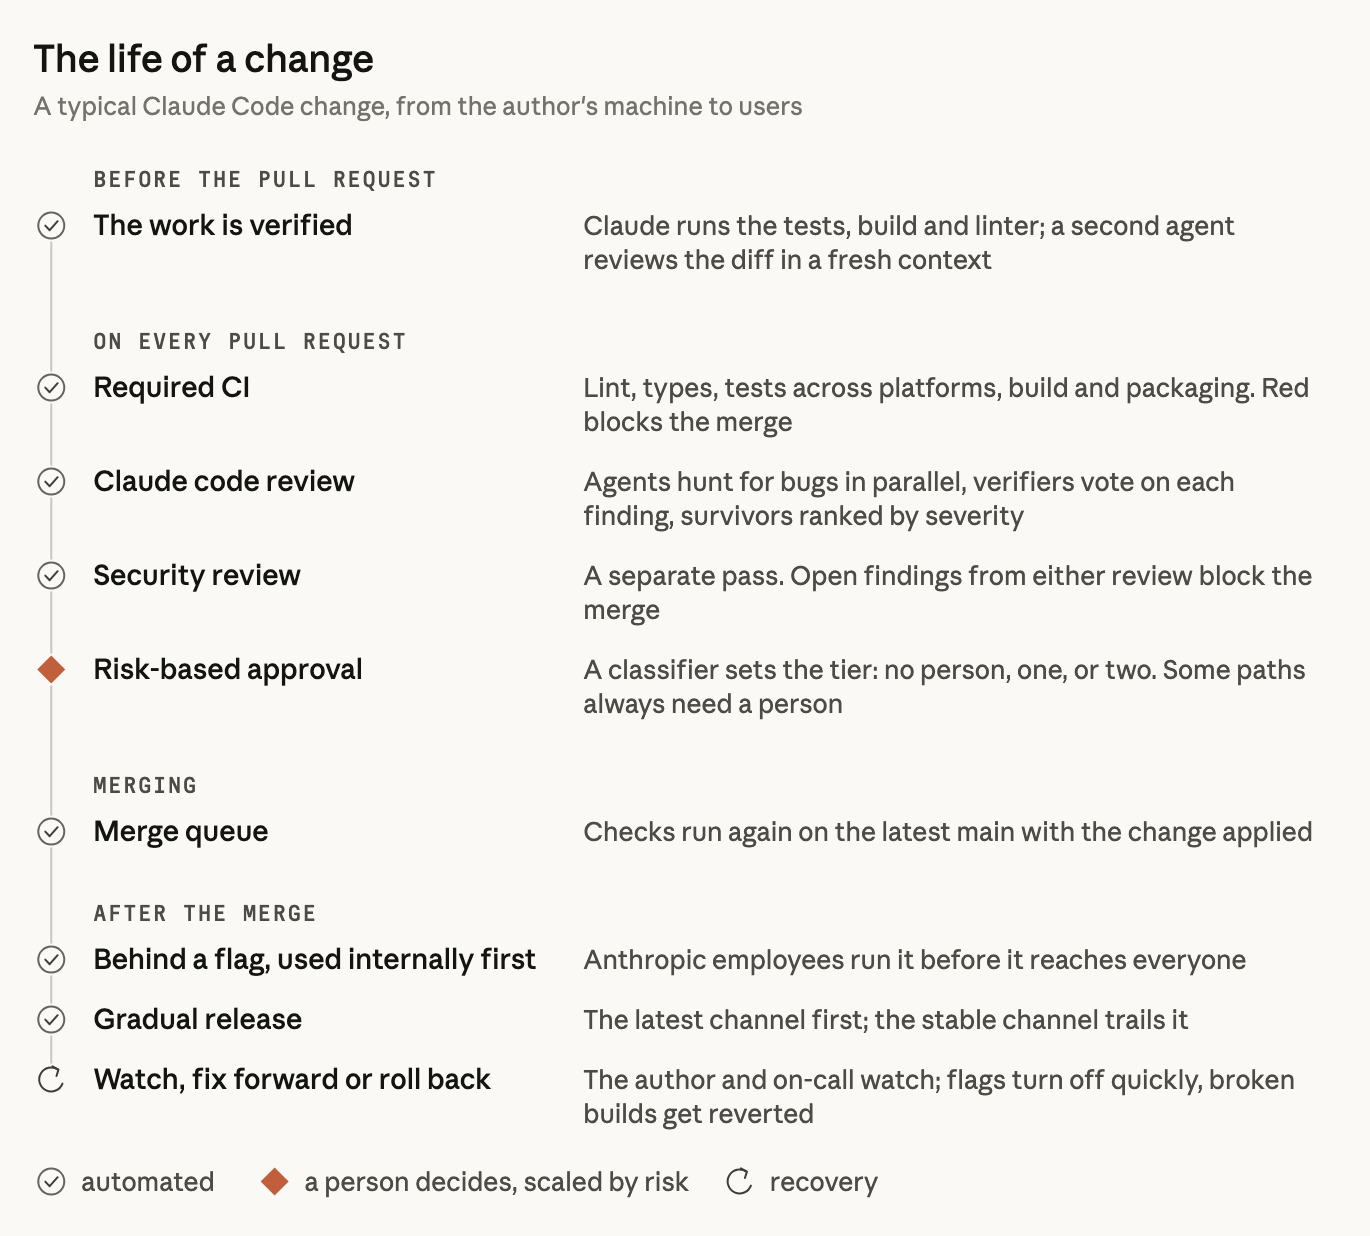
读图:从上到下分四段,左边的图标说明每一步由谁做:圆圈打勾是自动(automated),橙色菱形是"由人决定,按风险伸缩",回旋箭头是补救(recovery)。
| 阶段 | 步骤 | 做什么 |
|---|---|---|
| PR 之前 | The work is verified(自证) | Claude 跑测试、构建、lint;另一个 agent 在全新上下文里审 diff |
| 每个 PR | Required CI | lint、类型检查、跨平台测试、构建打包,红了就不能合 |
| Claude code review | 多个 agent 并行找 bug,verifier 对每条发现投票,留下的按严重程度排序 | |
| Security review | 单独一遍;两种审查里任一有未关闭的发现,都阻断合入 | |
| ◆ Risk-based approval | 分类器定档:不需要人、一个人、两个人;有些路径永远要人 | |
| 合入 | Merge queue | 在已经合上这次改动的最新 main 上重跑检查 |
| 合入后 | Behind a flag, used internally first | 放在开关后面,Anthropic 员工先用 |
| Gradual release | 先发 latest 渠道,stable 渠道跟在后面 | |
| ↻ Watch, fix forward or roll back | 作者和值班的人盯着;开关能快速关掉,坏掉的构建直接 revert |
【解读】九步里只有一个橙色菱形:人只在"按风险审批"这一处出现,而且出不出现、出几个人,由风险决定。
【原文】Fig B 把同一条路径画成六层检查,下面垫着回滚。
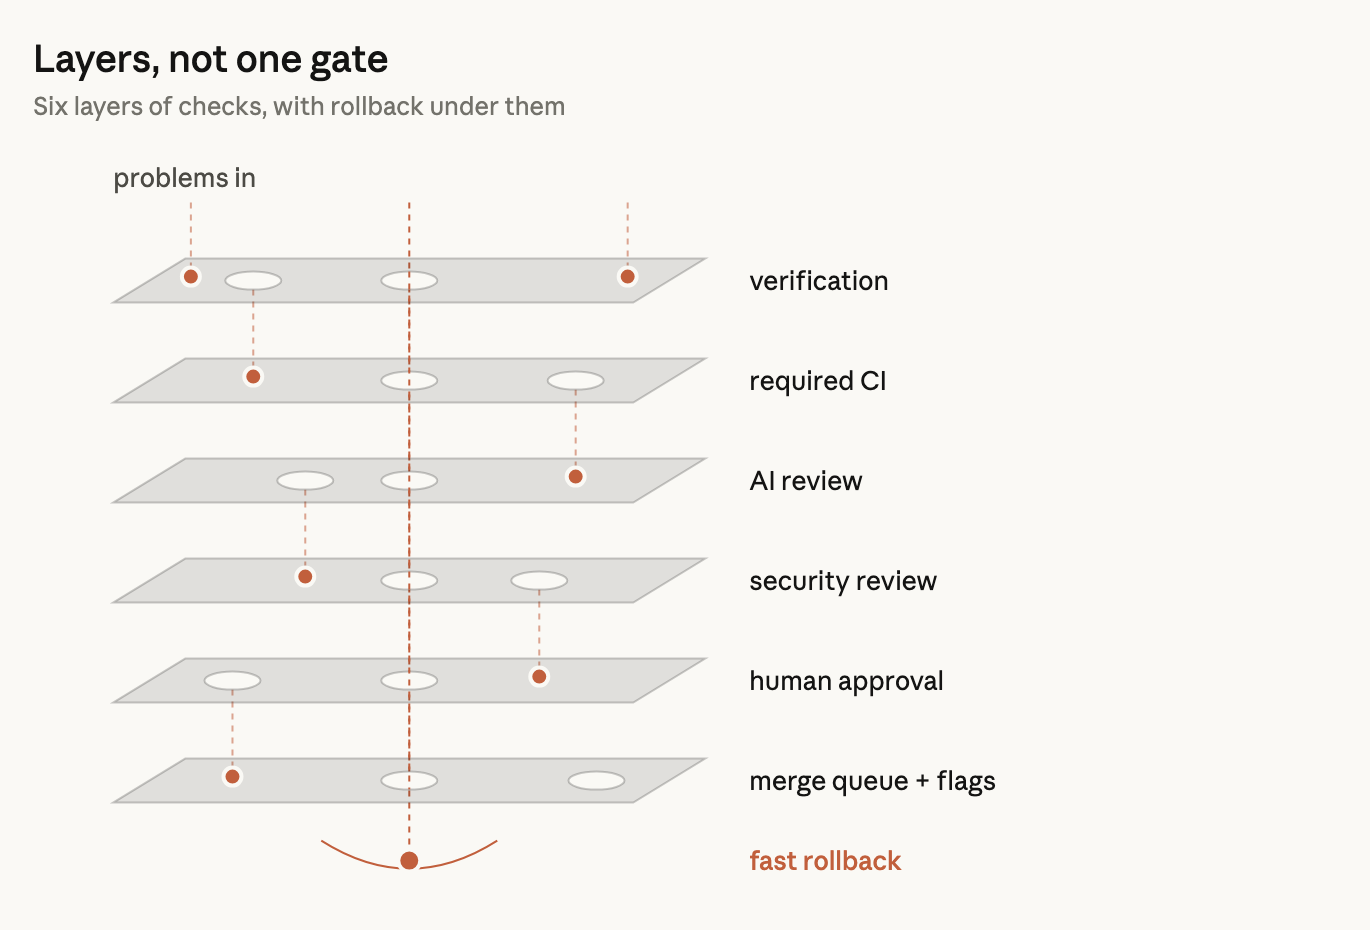
读图:六层从上到下是 verification(自证)、required CI、AI review、security review、human approval、merge queue + flags。每层都有几个洞,位置各不相同。问题从顶部(problems in)掉下来,多数穿过一两个洞,就落在下一层没有洞的地方被接住。只有正中那一列,六层的洞恰好对齐,问题一路掉到底,落进橙色的 fast rollback(快速回滚)。图里 CI 排在第二层,正文的编号是 1 自证、2 AI 审查、3 安全审查、4 CI,顺序不影响图要说的意思。正文编号 1 到 7,第 7 节就是图里垫在最底下的那层回滚。
【解读】这在安全工程里叫瑞士奶酪模型:每片奶酪都有洞,叠在一起之后,同时穿过所有洞的问题就很少了。
3.1 第 1 层:别人看之前,先自证
【原文】大部分审查现在发生在 PR 出现之前。三个习惯:
- 给 Claude 能跑的东西,并要求它贴出输出,而不是只说"做完了"。可以是测试、构建、和设计稿对比的截图。
- 用全新上下文的子 agent 审 diff。
- 开 PR 前跑几个内部 skill:一个找 bug,一个精简 diff,一个端到端检查行为;UI 改动还要对照设计规范检查。
Claude Code 的作者 Boris Cherny 认为,给 Claude 一个验证自己工作的手段,可能是拿到好结果最重要的一件事,估计能让最终结果好 2~3 倍。验证方式因领域而异:可能是跑一条 bash 命令、跑测试套件,也可能是在浏览器或手机模拟器里试用。
同一个问题被反复指出,就去源头修:改 skill、加 lint 规则,或者更新下面两个文件。
| CLAUDE.md | REVIEW.md | |
|---|---|---|
| 谁写 | 项目 | 这块代码的 owner |
| 写什么 | 项目是什么:技术栈、规范、目标、非目标 | 在这块代码里,什么才算出了问题 |
| 要点 | 每次审查都会加载,所以大仓库里要写短,细节链到别的文档;reviewer 会标出违反规范的代码,也会标出让 CLAUDE.md 某句话过时的改动 | 好的 REVIEW.md 都很短:写清失败是什么样(文档的失败是"写错了",配置的失败是"路由错了");限制 nit 数量;列出不审的路径;要求用文件 + 行号作证据,不能看名字猜;总结开头先报数量,没问题就直说没问题 |
他们还会单独检查 reviewer 有没有真的按 REVIEW.md 执行。
【解读】为什么要"全新上下文":写代码的 agent 带着自己的推理过程,容易顺着原来的思路替自己找理由;新上下文只看 diff,不受这些影响。
3.2 第 2 层:每个 PR 都过一遍 AI 审查
【原文】
- reviewer 结合 diff、整个仓库和 PR 写明的意图,判断三件事:解决问题了吗?和现有系统合得来吗?会不会弄坏别处?如果是修 bug,还要找根因。
- 研究预览上线后,有实质性评论的内部 PR 占比从 16% 升到 54%。1000 行以上的 PR 大多会被审出问题,小 PR 大多没问题。
- 管理员按仓库选 Quick / Standard / Deep。只有漏一个 bug 的代价超过多花的审查时间时,才值得用 Deep。
- 核实机制:多个 agent 并行找 bug,再由另一组 agent 投票,足够多的认为是真问题才发出来。只涉及风格、诊断信息或清理的意见直接丢掉。这些过滤规则先在他们自己的 PR 上做过 A/B 测试才定下来。
- 剩下的意见按严重程度排序,以行内评论发出,每条标 Important / Nit / Pre-existing。Pre-existing 表示这是原来就有的 bug,免得看起来像作者的锅。
- 每条意见都必须回应:要么修掉,要么写明理由关闭。很多时候 agent 夜里就把修复做了,作者回来看到的是已经又过了一轮的 PR。
【解读】找 bug 的一组负责多找(召回),投票的一组负责去噪(精确率),两件事分开做。
3.3 第 3 层:能阻断合入的安全审查
【原文】安全有单独的自动审查。bug 审查或安全审查只要还有一条意见没关闭,PR 就不能合入。误报写一句理由关掉;后续 commit 修好了问题,意见会自动消失。本地用 /security-review,CI 用开源的 security review GitHub Action。
3.4 第 4 层:会阻断合入的 CI
【原文】lint、类型检查、各平台测试、构建。一个 CLI 的 PR 在人看之前可能要跑几十项检查。PR 模板会问:怎么测试的?怎么撤销? Claude 可以填,但提出这个改动的人要签字确认。
【解读】"怎么撤销"这一栏是在为第 6、7 层铺垫:写 PR 时就要想好退路。
3.5 【批判性阅读】评论变多不等于审查变好
16% → 54% 统计的是"有实质性评论的 PR 占比"。按文章自己在 5.2 节的标准,只看抓到了多少是不够的,还要看噪音。文章讲了噪音怎么测,但没有给出噪音的数字,所以单凭这组数据还看不出审查质量提升了多少。
4. 七层防线(下):审批、合入、回滚
4.1 第 5 层:人工审批,按风险分级
【原文】
| 风险 | 例子 | 需要几个人批准 |
|---|---|---|
| 低 | 文档、文案、只给内部用的功能、放在开关后面的新增功能 | 自动审查和安全检查都通过后,不需要人 |
| 中 | 普通产品改动,以及缓存、自动更新器、系统提示词这类敏感区域 | 1 人 |
| 高 | 风险最高的代码,以及少数规定必须两个人看的路径 | 2 人 |
四条规则:
- 风险等级由改动本身决定,不由作者决定。一个分类器读完改动来定级;另一个分类器再问"按等级不需要人,但这次改动是不是还是该有人看"。owner 标为敏感的路径和所有 CI workflow 文件,不管等级都要人看。
- 轻量审批只给受信任的作者。不在仓库信任名单里(名单主要是负责这个仓库的团队)的人,要再找一个人批准。agent 的批准永远不算人的批准:自动审查可以放行低风险改动,但不能顶替需要人的环节。
- 谁给 agent 下的指令,谁就要负责。agent 写的 PR 里,指挥它的人算作必需的审查人之一,和自己亲手写一样。
- 批准只对某一个 commit 有效。批准之后又进来系统无法担保的 commit(agent 又推了一次,或有人手动解决了合并冲突),就要重新批准。
【解读】CI workflow 文件一定要人看,是因为它定义的是检查本身,改了它就是改了关卡。agent 遇到检查不过时,最省事的"修法"就是把检查改松。
4.2 第 6 层:merge queue、功能开关、逐步放量
【原文】
- merge queue 把每个 PR 放到最新的 main 上重跑全部检查,两个各自都通过的 PR 合在一起也不会把 main 弄坏。
- 新功能通常先藏在开关后面,先给 Anthropic 员工用。他们自己用得很重,回归往往在用户之前就暴露了。
- 对外发布先进
latest通道,stable通道晚一步跟进。
【解读】"各自通过、合起来坏掉"的例子:PR A 把函数 foo 改名为 bar,PR B 新增了一处 foo() 调用。两边各自基于旧 main 测试都是绿的,合到一起 B 调用的函数已经不存在了。
4.3 第 7 层:快速发现、快速回滚
【原文】
- 还是会有错误漏过去,所以最后一层的目标是尽快发现。开关不需要重新发版就能关。
- Claude Code 有每周轮换的 on-call。事故复盘会问:这个问题本该被哪一层拦住?
- 文章承认的缺口:发现坏的合入,目前还是靠作者、on-call 和 revert / 事故看板。他们还没有"熔断器",也就是这些数字变化时自动收紧审批的机制;工程师们希望先有熔断器,再让更多代码零人工合入。
- 一位同事的看法:放慢确实会降低出错率,但主要是因为什么都做得少了。他们宁愿更快地发现和修复问题。
4.4 【解读】能撤销,本身就能减少审查
第 5 层的表格里,"放在开关后面的新增功能"被归为低风险。说明在他们的定义里,风险不只看改动多大。我把它概括成(个人概括,原文未这样写):
风险 出错的概率 影响范围 撤销需要的时间
开关压低了后两项,所以它不只是兜底的保险,而是直接让这个改动需要的人工审查变少。PR 模板里"怎么撤销"那一栏也可以这样用:如果答案是"撤不了,只能等下一版过审",这个改动就要么加开关,要么提高风险等级。
5. 让 reviewer 越来越好
【原文】审查流程本身在一个循环里持续改进。
5.1 把事故变成 eval(管召回)
【原文】团队收集了过去引发事故的 PR,连同后来的修复(fix-forward)和 revert,请熟悉那块代码的工程师逐条确认 bug 是什么、在哪。reviewer 每天在这个集合上跑一遍。
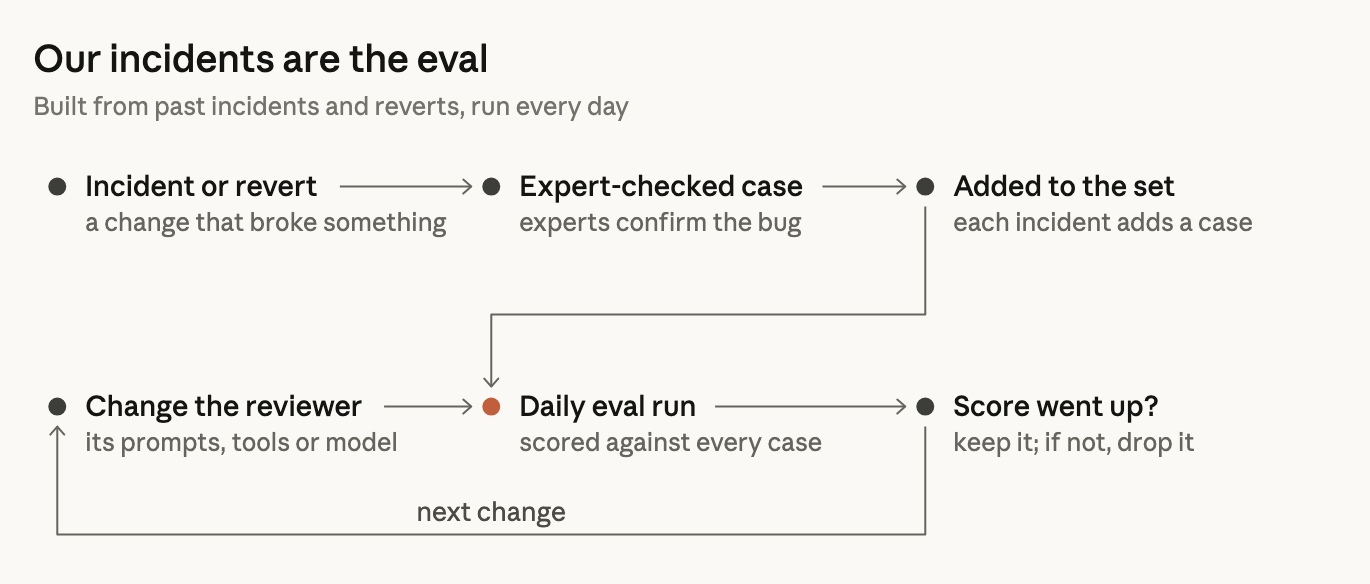
读图:两条线在橙色的"Daily eval run"(每日评测)处汇合。
- 上排管集合怎么长:Incident or revert(一次弄坏了东西的改动)→ Expert-checked case(专家确认 bug)→ Added to the set(每次事故加一条);
- 下排管 reviewer 怎么改:Change the reviewer(改它的 prompt、工具或模型)→ Daily eval run(对集合里的每一条打分)→ Score went up?(涨了保留,没涨丢掉)→ next change,回到下一次改动。
【解读】没有这个集合,调 reviewer 只能凭感觉:改了一句 prompt,不知道是不是因此漏掉了原来能抓到的 bug。而且它是自己真正上线过的 bug,比通用 benchmark 更贴近要防的东西。
下排那一圈就是评测爬山笔记 Fig 6 的循环。不同的是这里只有一份集合,没有留出的测试集。好在集合随事故持续增长,每条新事故对 reviewer 来说都是没见过的题。
5.2 看作者怎么回应,衡量噪音(管精确率)
【原文】
- 只要不在乎误报,多抓 bug 很容易,所以需要一个对冲的检查。
- 把 reviewer 的每条意见按作者的回应分类:修了 / 认为意见是错的 / 说明是故意这样写的 / 觉得无所谓。
- 在已知没问题的 PR 上跑 reviewer,数它有多少次报出会诱导人做出有害改动的问题。
- 优先级明确写下来:第一是抓真 bug,第二才是减少审查轮次。
- 作者是 agent 时噪音更贵:人几秒钟就能忽略一条 nit;agent 会去修,于是多一个 commit、多一轮审查。
【解读】第二种测法的重点在"有害改动":关心的不只是误报本身,而是误报被照着改了之后代码变差。只盯召回而不测噪音,又是 2.4 节说的单一指标问题。
5.3 审查必须收敛
【原文】
- agent 作者和 agent reviewer 可以无限地互相制造工作。一个 CLI 的 PR 一夜之间审了又修、修了又审 50 多轮,最后作者手动叫停。
- 对 reviewer 反复报的代码做 git blame,约 59% 在 reviewer 第一轮审查时就已经存在。reviewer 很少发现新 bug,而是每轮多挖出几个老 bug。
- 他们承认是自己让情况更糟:习惯了默认跑好几轮,因为每轮都能多抓一点。高风险改动值得这样做,但不是每个 PR 都值得。
- 现在把审查轮次和召回一起跟踪,并改了复审规则:
- 轮次上限:三轮之后,reviewer 让作者停下来,重新考虑方案;
- 前几轮之后只审新增的 diff;
- 按 bug 类别报,让作者一次把同类问题全修掉,而不是只改一行;
- 已经报过的问题不再重复报。
- 另外,审查 agent 每天夜里会扫一遍现有代码,老 bug 在别处冒出来之前先抓住。
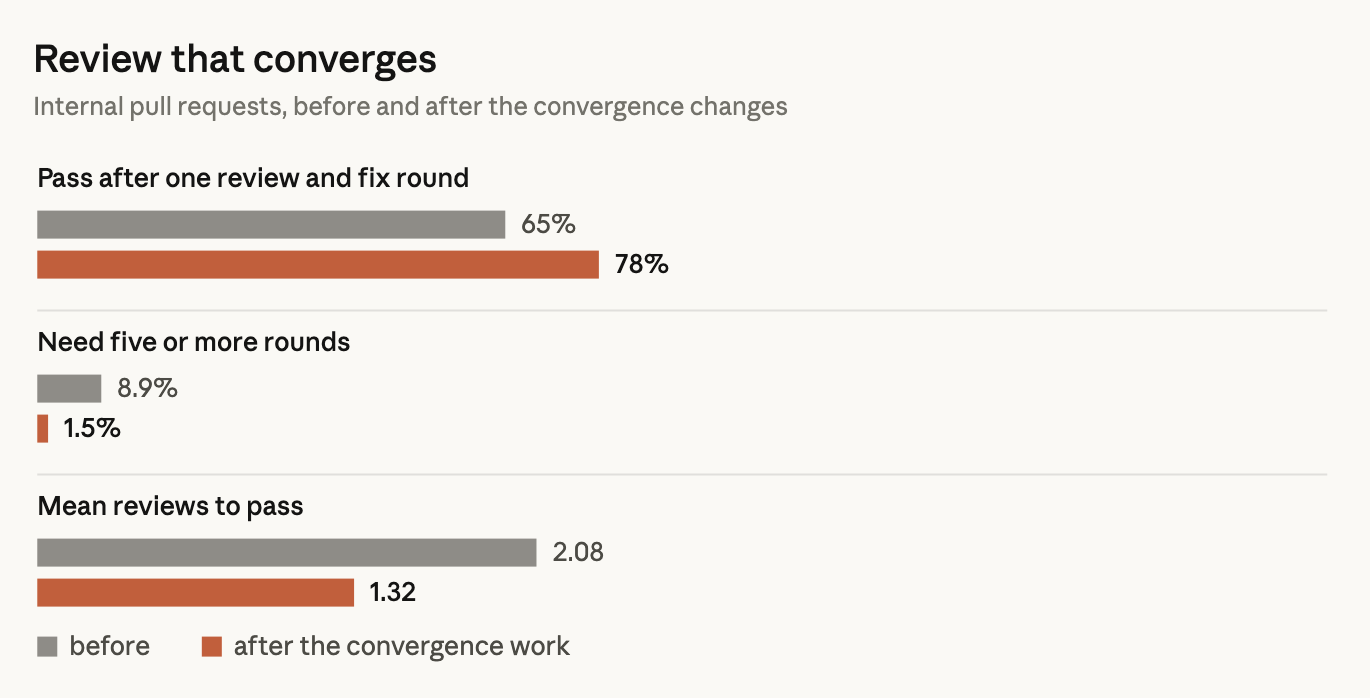
读图:三组柱子,灰色是改之前,橙色是改之后(after the convergence work):
| 改之前 | 改之后 | |
|---|---|---|
| 一轮审查和修复后就通过 | 65% | 78% |
| 需要 5 轮及以上 | 8.9% | 1.5% |
| 平均审查次数 | 2.08 | 1.32 |
【解读】
- 59% 这个数可以这样理解(个人推测,原文未说明):一次 LLM 审查相当于一次抽样,每轮只能看出全部问题的一部分。大 PR 里老问题多,再做一次全量审查就会再抽出几个。所以"每轮都有新发现"既不说明代码越改越差,也不说明应该继续改。
- 这一节最重要的设计是把两件事分开:这个 PR 引入的问题在 PR 流程里处理,必须收敛;代码库里原有的问题交给夜间扫描,按自己的节奏处理。3.2 的 Pre-existing 标签、这里的只审新 diff 和夜间扫描,都是为这个划分服务的。
5.4 小结
| 要管的 | 衡量什么 | 怎么做 |
|---|---|---|
| 召回 | 真 bug 抓到了多少 | 事故做成 eval,reviewer 有任何改动就重跑 |
| 噪音 | 假问题报了多少 | 记录每条意见的结局;在已知干净的 PR 上测误报 |
| 收敛 | 几轮能通过 | 轮次上限、只审新 diff、按类别报、不重复报,老 bug 交给夜间扫描 |
6. 人的角色、团队理解与文化
6.1 人保留的五件事
【原文】把资深工程师从深度工作里拉出来抓一个常规错误,代价远高于跑一遍自动审查。人的工作从"读每一份 diff"转向机器不擅长的决策,五类决策留给人,其余全是检查:
- 这个该不该做:方向、品味、范围。有个团队已经宣布审查瓶颈解决了,但外部团队的改动仍然要人审,为的是有人问一句"这事到底该不该做"。
- 高风险代码:计费、自动更新器、CI workflow。
- 会被别人照抄的架构。
- 读证据:测试输出、实际跑的命令和返回、截图、reviewer 的意见。如果说不出这些检查会漏掉什么,就别快速批准,要求认真审一遍。
- 对结果负责:每个上线的改动都有一个人负责,不管代码是谁敲的。
6.2 机器读代码以后,人怎么懂代码
【原文】
- 没有正式流程。团队里没人脑子里装着 Claude Code 的完整结构,他们也认为没人需要。
- 想了解哪一块,就让 Claude 针对这一块写讲解,几分钟就好,反映的是代码当前的样子。
- 有人更进一步,让 Claude 做一个小的可视化页面,按自己喜欢的方式讲这块代码。
- 这比逐行读零碎 diff 划算:一行文案改动几乎学不到东西,你要改的模块的讲解能学到很多。
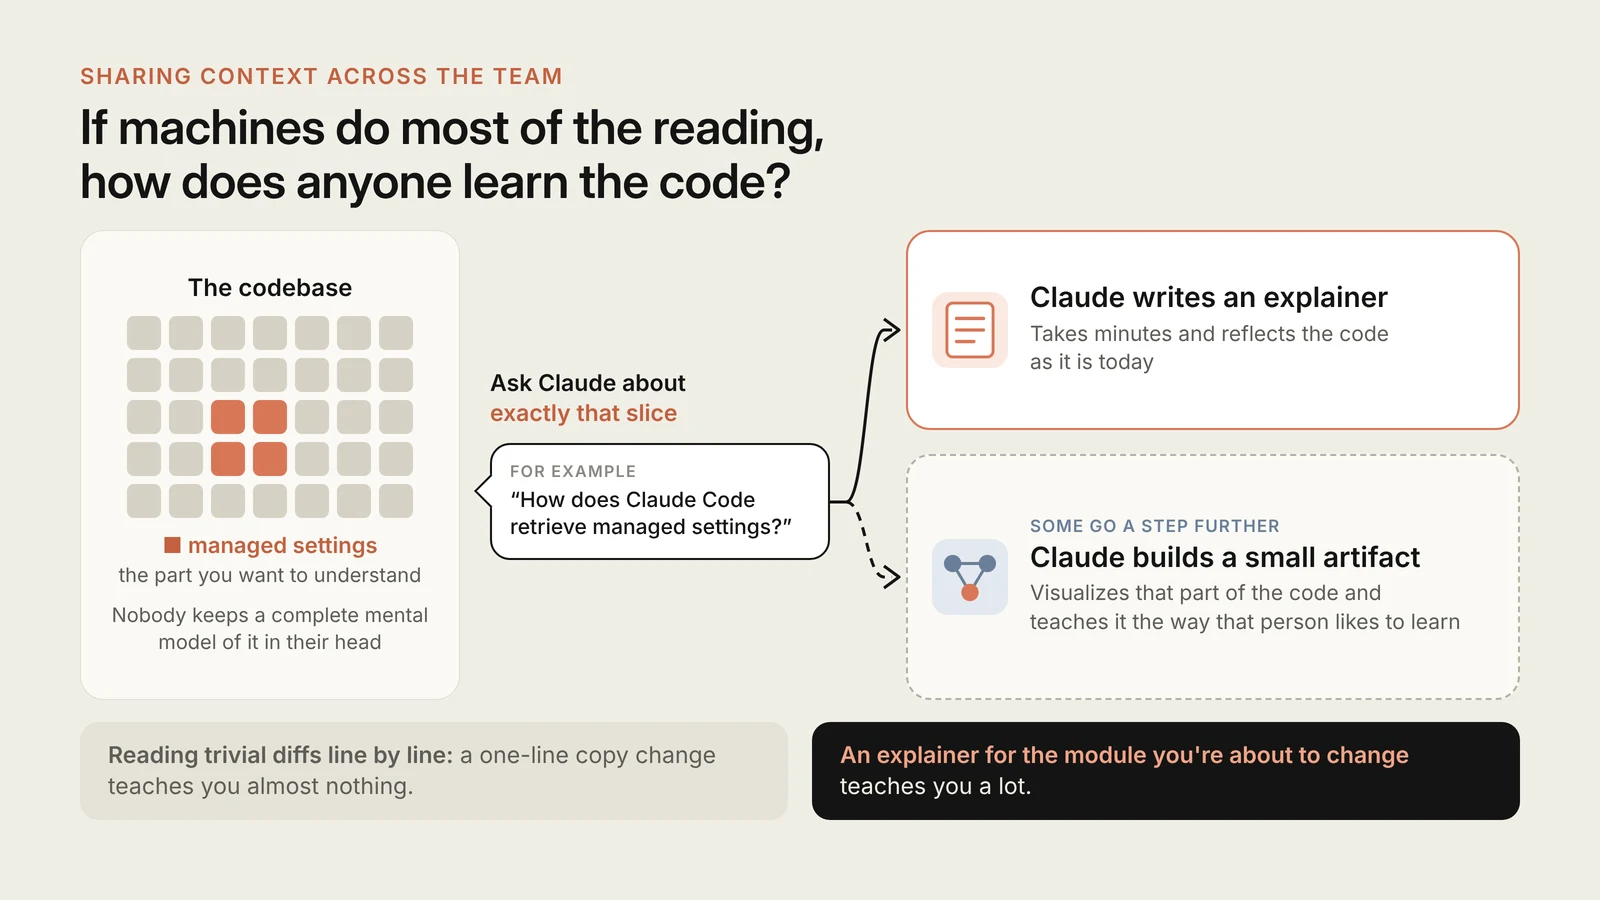
读图:
- 左:代码库(The codebase)是一片方格,高亮的几格是 managed settings,即你想弄懂的那一块。图注写着"没人脑子里装着完整的模型";
- 中:针对恰好这一块问 Claude(Ask Claude about exactly that slice),例子是"Claude Code 怎么读取 managed settings?";
- 右:实线指向"Claude 写一份讲解",几分钟,反映代码现在的样子;虚线指向"有人更进一步",让 Claude 做一个小页面,可视化这块代码,按这个人喜欢的方式讲;
- 底部对比:灰底是逐行读零碎 diff,一行文案改动几乎学不到东西;黑底是读你要改的模块的讲解,能学到很多。
- 团队默认在公开的 Slack 频道里工作,别人在做什么,做的过程中就看得见。
6.3 "谁合入,谁负责"
【原文】中小改动合入后出了问题,团队规矩是一般由你来修。能行得通靠五个前提:
- 改动小:容易审、容易查、容易撤;
- 都能撤销:开关、revert、分阶段发布,几分钟撤掉大部分错误;
- 影响范围决定审查力度:代价高的代码,审的人更多,检查更多;
- 回归暴露得快:靠线上监控数据和内部使用;
- 不是追责:由你修是因为你上下文最多;事故复盘看的是系统。
责任也是共同承担的:在公开频道里,谁都能看到、接手,或者派一个 Claude 去补缺口,不负责这块代码的人也会给反馈。文章认为这种公开是不对每一行设卡也能保持质量的重要原因。
【解读】这个文化建立在机制上。没有"能撤销"和"暴露得快","谁合入谁负责"就会变成压力,人一有压力就会放慢、加关卡,最后又回到每行都要人审。
6.4 方向不对,早点关
【原文】agent 让开头变得很便宜,所以有些工作本来就不该合入。通常是频道里有人问为什么、指出以前的决策,或者提出更简单的路,作者就关掉或重新调整 PR。代码写得快,关掉也不觉得可惜。关键是换方向的意见要尽早在讨论里提,而不是等 PR 写完了再留一条阻止合入的评论。
【解读】agent 时代最贵的错误往往不是代码写得差,而是把一件不该做的事做得很好。
7. 落地清单与方向
7.1 文章的落地清单
【原文】(按阶段归纳)
PR 之前
- 给 agent 能跑的检查,写进一份简短的 CLAUDE.md;用 hooks 自动跑格式化和 lint
- 本地跑
/code-review、/security-review,或者用全新上下文的子 agent 审 - 加一个 REVIEW.md,把反复出现的审查意见写进去
每个 PR
- CI 必须通过;PR 模板加上"怎么测的 / 风险 / 怎么撤回"
- AI reviewer 先在一个仓库上用,调几周 REVIEW.md,再推广
- 加自动安全审查;所有审查讨论都关闭才能合入
- 审查力度跟着风险走:常规改动快速过,漏一个 bug 代价大的深审
- 限制审查轮次;前几轮之后只审新 diff
审批
- 把风险分级写下来,按改动定级,不按作者;先严,有证据再放松
- 轻量审批只给信任的作者
- 用 CODEOWNERS 和分支保护,让认证、计费、CI / 发布流程、安装器必须有人批
- bot 的批准不能代替必需的人;有新 commit 就作废之前的批准
合入之后
- merge queue、功能开关、内部先用、分阶段发布、一键回滚
- 把事故和 revert 做成 eval;reviewer 的 prompt、工具、模型一变就重新打分
- 衡量人花的时间,把 revert 率和事故率当护栏
【解读】清单里藏着两条落地原则,容易看漏:先严后松,有证据再放松;先一个仓库,调好再推广。整套东西是一步步放开的,不是一次全上。
7.2 文章最后讲的方向
【原文】
- Code Review 的发布文章说过,批准 PR 仍然是人的决定,产品只发意见不发批准。他们自己的仓库走得更远:由 owner 决定哪些低风险改动只靠自动检查就合入,这条线还在往前移。
- 审查漏了问题时,他们会问模型当时缺了什么信息,再把补上的东西写进 CLAUDE.md、skill,或者加一项新检查。
- 目标没变:每个改动花的人时间更少,revert 不比以前多。
【解读】他们把漏检当作上下文缺口,而不是"模型不够聪明"。这决定了补救动作是补信息、补检查,而不是换模型或加人。
8. 延伸思考一:对照我的四道关
8.1 我的流程
我的工作模式和文章很像:agent 产出大量代码,人根本来不及看。现在的流程是:
- 测试驱动:先写测试再写代码,测试也由 agent 写。修 bug 时先写一条测试看它变红,修完让它变绿。
- Claude 预审:改动面足够大(我主观判断)时,再起一轮多 agent 对抗审查。
- 危险功能我自己看 diff 挑刺:比如支付、直接影响机器性能的改动。改动很轻的一般不看。
- 移交 QA:专业测试人员把最后一关。
然后上线。
8.2 和文章对照
| 我的关卡 | 对应文章 | 一致的地方 | 不同的地方 |
|---|---|---|---|
| ① TDD | 第 1 层:PR 前自证 | 给 agent 能跑的检查 | 文章还要求贴出运行输出,并补测试覆盖不到的验证(截图、端到端) |
| ② 预审 + 大改动对抗审查 | 第 1 层子 agent + 第 2 层 AI 审查 | 多 agent 找 bug,分组投票 | 文章每个 PR 都审,只是深度按风险调;每条意见都必须回应 |
| ③ 危险功能人看 diff | 第 5 层:风险分级审批 | 人力按风险分配 | 文章由改动本身定级(分类器 + 敏感路径清单);敏感路径改动再小也要人看 |
| ④ QA | 文章没有专职 QA,对应第 6、7 层 | 上线前最后一关 | 文章的重点是出了错能马上撤:内部先用、灰度、一键回滚 |
| — | 文章有、我没有 | 度量(人时间 + 返工率);事故回流成 eval |
8.3 三个主要差距
- 两个关键判断靠主观:第二道坎的"改动面足够大"和第三道坎的"改动很轻"。文章的原则是风险由改动本身决定,而 diff 大小不等于风险。支付代码里改一行(价格常量、金额取整、订阅状态判断)可能就是最危险的改动。按瑞士奶酪模型看,主观触发等于有时候那片奶酪根本不在。
- 四道关全是"防",没有"撤"和"发现":缺第 6、7 层。
- 没有度量,也没有回流:没有护栏数据,就不知道哪道关可以放松;QA 抓到的 bug 没有反过来变成前几道关的检查。
8.4 测试:先红再绿之后还有两处漏洞
先红再绿这一步很关键:从没失败过的测试证明不了它能发现问题。还要补两处:
- 红要红在断言上。测试变红可能是编译错误、import 写错、环境没起来,而不是测到了 bug,之后"修"绿了什么也没证明。让 agent 贴出变红那次的输出,确认是断言不通过。
- 变绿阶段 agent 可能改了测试本身:放宽断言、改期望值、跳过 case。这是 agent 写 TDD 的常见失败。办法是变红后锁定测试文件;变绿阶段的 diff 里改到了测试断言就单独标出来,要求写理由。
另外,测试和代码出自同一个 agent,它对需求理解错了,两者会一起错。成本最低的补法是写代码之前花一两分钟扫一眼测试用例清单:用例清单就是需求说明,比读代码快得多,也是 6.1 说的"读证据"。
8.5 对抗审查:结构一致,第二组问的是另一个问题
我的对抗审查分两组:
- 第一组找问题,形成候选清单,不直接算 bug;
- 第二组按我的原则反驳:(a) 有没有必要修,是不是亿万分之一概率才发生(这种不修);(b) 修复有没有破坏现有架构、改动面是不是太大;(c) 改动干不干净;
- 最后投票选出要修的。
"一组找、一组驳、投票"和文章的做法一致,差别在第二组判断什么:
| 文章的第二组 | 我的第二组 | |
|---|---|---|
| 判断的问题 | 这个 bug 是不是真的(真问题还是误报) | 这个 bug 值不值得修、怎么修(必要性、对架构的影响、干不干净) |
两个问题放在一轮里判,有两个风险:
- (b) 可能把严重的真 bug 投掉:一个又真又重的 bug,干净的修法要大改,按"改动面太大"会被否掉。这种情况应该交给人,"修一个 bug 要动架构"正是 6.1 里人保留的架构决策。
- (a) 在支付和安全代码上要换算法:一亿次一次说的是正常使用的随机概率,攻击者不会等随机概率(比如故意重放凭据)。先问"有没有人能故意触发它",能就等于概率接近 100%;不能,也要看概率 影响,概率极低但一发生就是资损的照样要修。
改进:
- 第二组结论从"修 / 不修"改成三种:修 / 不修(写理由)/ 交给人。"写理由"对应文章的"每条意见都必须回应"。
- 我的这几条原则本身就是一份 REVIEW.md,写成文件,每次审查都加载同一份,再检查 agent 有没有照着执行。
- 衡量这两组的效果:每条通过投票的意见记录最后结局(5.2 的四类),"认为意见是错的"占比高说明筛得太松;QA 每抓到一个 bug,回查它当时在不在第一组的候选清单里——不在,是"找"漏了;在但被投掉,是"筛"太严。召回就这样拆成找到率和保留率两段,知道该调哪一组。
- 收敛:设轮次上限,超过就交给我判断;轮次多通常说明改动太大该拆,或者方案本身有问题。发现的老问题打 Pre-existing 标签记进 backlog,不在这个 PR 里修;后几轮只审新 diff。
8.6 第三道坎:从"挑刺"改成"问检查会漏掉什么"
- 按功能判断"危险",这一点和文章的敏感路径一致;问题在"改动很轻就不看",这是按 diff 大小跳过人工。
- 列一份敏感路径清单:支付模块、凭据校验接口、权益发放逻辑、性能热点路径、CI / 构建配置。人工投入分三档(结合我的情况改编,非原文):
- 不用看:没碰敏感路径;
- 看证据:碰了敏感路径但改动轻,看验证 skill 跑出的
transactionId和数据库查询结果,一分钟左右; - 看 diff + 证据:碰了敏感路径且改动大,或者涉及架构。
- 改到检查本身的一律要人看:测试文件、CI 配置、REVIEW.md、验证 skill。
- 4.1 的第 4 条对我很实际:我看完支付 diff 后对抗审查又跑了几轮、agent 又改了代码,我看的就不是最终版了。要么等自动审查收敛了再看,要么看完后只重看新增的 diff。
- 性能类风险可以挪到第一道坎:光看 diff 很难看出性能会不会变差,跑一次 benchmark 就有数字,我只看数字。
- 看支付 diff 时,问这四个问题,而不是挑常规错误:
- 这次改动可能的失败,REVIEW.md 里写了吗?没写就补;
- 验证 skill 覆盖了哪些失败,没覆盖哪些?
- 有没有改到检查本身?
- 出了问题能不能撤?
8.7 第四道坎和上线后
- 给 QA 的交接说明(6.2 按需讲解的直接用法):每次提测前让 Claude 生成,写清改了什么、风险等级、重点测哪些失败场景(从 REVIEW.md 取)、自动检查已经覆盖了什么、没覆盖什么。QA 就能把精力放在自动化测不到的地方。
- iOS 上的对应物:TestFlight 内部测试对应"员工先用";App Store 分阶段发布(7 天内按比例推送自动更新,可暂停)对应
latest→stable;远程开关对应 flag,已有 A/B 实验的远程配置可以顺便当总开关。客户端发出去收不回来,"快速撤销"只能在发版前预先做好。 - 并行 agent 多了以后,4.2 那种改名冲突迟早出现,用 GitHub merge queue 或 GitLab merge train。
- 让 agent 把大改动拆成小 PR:文章里 1000 行以上的 PR 大多会审出问题,大 PR 老问题多、更难收敛,拆小后审查轮次、撤销成本、定位难度一起降。
- 方向检查放在看测试用例清单的时候:我的四道关检查的都是"做得对不对",没有一道检查"该不该做"。写完测试、还没写代码时问"这个该不该做、范围对不对",代价最小。
9. 延伸思考二:苹果支付的验证链
9.1 我的验证 skill
之前做苹果支付自动化时,给 agent 定过一个验证流程:
- 先检查状态码,并且拿到完整的返回输出,而不只看状态码;
- 再用只读账号的数据库 CLI 连上开发测试库,按时间戳流判断是不是真的支付成功。
【解读】三点做对了:拿完整返回,就是 3.1 的"拿输出当证据,不听它说做完了";只读账号权限最小,验证时不会误改数据;用数据库时间戳交叉核对,是换一个独立的证据来源。
9.2 验证会怎么骗人:三问
我想到的失败:
- 返回的状态码是成功,但可能是脚本误判、误报;
- 返回成功了,但没去看数据库,测试实际上并没成功。
第三种当时没想出来。整理成验证链的三问:
- 接口说成功了吗?(对应我的第 1 条)
- 真的写进数据库了吗?(对应我的第 2 条)
- 写进去的是这一笔、只有一笔、而且后续环节都完成了吗?
- 查到的是旧记录:时间窗口太宽,查到上一次测试留下的成功记录。应该用这次购买的
transactionId精确匹配,而不是看"最近有没有一条成功的"。 - 重复处理:同一笔交易被处理两次,比如交易没有 finish,苹果下次会重新推送(待验证:具体重推时机以 StoreKit 文档为准)。要查的是"恰好一条",不是"有没有"。
- 入库不等于用户拿到权益:订单写进去了,权益没发,或者客户端没解锁。
- 查错了环境:连的库和服务端实际写入的库不是同一个环境。
- 查到的是旧记录:时间窗口太宽,查到上一次测试留下的成功记录。应该用这次购买的
9.3 支付代码本身的失败:REVIEW.md 示例
学习时这道题本来问的是"给支付代码写 REVIEW.md,失败是什么样",我回答的是"验证本身会怎么失败"。两件事要分开:9.2 是验证会怎么骗你,属于第 1 层;下面是支付代码本身怎么出事,是 REVIEW.md 要写的。按 3.1 的标准写短:
# REVIEW.md:苹果支付

## 什么算失败
1. 扣了钱,没给权益
2. 没付钱(凭据伪造或被重放),却给了权益
3. 同一笔交易被处理两次(重复入库 / 重复发权益)
4. 退款或过期后,权益没收回

## 证据
- 每条意见给出文件 + 行号,不允许看函数名推测

## 不报
- 纯命名或格式问题,Nit 每次最多 3 条

## 输出
- 开头先写「Important N 条 / Nit M 条」;没有问题就直接写「无需修改」
9.4 成功判据与生产对账
- 验证 skill 检查的就是 REVIEW.md 里的那些失败。成功判据可以定成:这个
transactionId在本次运行的时间窗口里恰好一条记录、状态正确、权益已发放。 - 支付的轻改动不必每次看 diff,但一定看证据:skill 跑出的
transactionId和查询结果。判断规则用 6.1 那句:说不出检查会漏什么,就认真审。 - 第 7 层在我这里是空的,支付场景成本最低的补法:把验证 skill 以只读权限拿到生产环境,每天对一次账,比对苹果侧的交易和数据库里的权益记录。"扣了钱没给权益"QA 很难测出来,对账第二天就能发现。
10. 实践检查清单:我的改进方案
10.1 改进后的流程
0 方向     看测试用例清单:这个该不该做?范围对不对?
1 自证     TDD:红在断言上 → 变绿阶段不准改测试 → 性能跑 benchmark → 贴出运行输出
2 自动审查 每次都跑轻量审查;按规则触发对抗审查(行数阈值 / 命中敏感路径)
           第一组找问题 → 第二组判真假 + 值不值得修 → 修 / 不修(写理由)/ 交给人
           最多 3 轮,超过交给人;老问题进 backlog,不在本 PR 修
           加 /security-review
3 人       敏感路径必看:改动轻看证据,改动大看 diff + 证据;问"这些检查会漏掉什么"
4 QA       拿交接说明,重点测自动化没覆盖的部分
5 上线     远程开关 + 分阶段发布
6 发现     每日对账 + 监控;每个漏网 bug 问"本该在哪一层拦住" → 补进 eval / REVIEW.md / 检查
第 0、5、6 层是新增的;第 2、3 层把主观触发改成了规则触发。
10.2 第一批:本周能做,基本只是写文件
这一批专门堵主观判断留下的洞。
- 写支付的 REVIEW.md;把对抗审查的原则写成文件,(a) 补上"有没有人能故意触发"
- 第二组结论改成三种:修 / 不修(写理由)/ 交给人;超过 3 轮交给人
- TDD 两条规矩:红在断言上(贴输出为证);变绿阶段改测试单独标出
- 敏感路径清单 + 人工三档(不看 / 看证据 / 看 diff),替代"改动轻就不看";改检查本身的一律人看
- 加
/security-review
10.3 第二批:一两周,补"发现"和"度量"
- 支付每日对账:验证 skill 只读跑生产库,专抓"扣了钱没给权益"
- 验证链第三问:按
transactionId精确匹配,恰好一条、权益已发 - 记录每条审查意见的结局(四类);QA 每抓一个 bug 回查是"找"漏了还是"筛"掉了
- 用 10 条 QA bug 和线上 bug 起一个 eval:每条记出 bug 时的 commit、文件和行号、一句话描述
- QA 交接说明模板
10.4 第三批:要写代码,补"撤"
- 支付流程、付费墙等高风险客户端功能接远程开关
- App Store 默认分阶段发布
- 并行 agent 多了以后上 merge queue / merge train
- 度量:优化目标是我花在第三道坎上的时间,护栏是 QA 打回率和上线后 hotfix 数。护栏稳住了才放松某一档
先做第一批是因为成本最低、堵的正好是现在最大的洞。最后一条看起来排在最后,其实是之后所有"放松"的前提:没有护栏数据,就不知道哪一档可以松。
11. 术语表
| 术语 | 含义 |
|---|---|
| code review(代码审查) | 合入前对改动的检查;本文把它扩展成从写代码到上线后的多层检查 |
| revert | 把已合入的改动撤回 |
| fix-forward | 不撤回,直接再提一个修复往前修 |
| proxy metric(代理指标) | 拿来近似真正目标的指标,如"有人读过代码"近似"风险被拦住" |
| guardrail metric(护栏指标) | 优化主指标时必须不变差的指标,本文是 revert 率和事故率 |
| Goodhart's law(古德哈特定律) | 一个指标一旦成为目标,就不再是好指标 |
| fresh-context subagent | 不带写代码过程上下文、只看 diff 的审查子 agent |
| CLAUDE.md | 告诉 Claude 项目是什么:技术栈、规范、目标、非目标 |
| REVIEW.md | 由代码 owner 写,告诉 reviewer 这块代码里什么算失败 |
| finding | reviewer 报出的一条意见 |
| Important / Nit / Pre-existing | 意见标签:重要问题 / 小问题 / 原来就有、非本 PR 引入 |
| Quick / Standard / Deep | Code Review 按仓库设置的三档审查深度 |
| risk tier(风险等级) | 低 / 中 / 高,决定需要几个人批准 |
| trusted list(信任名单) | 可以走轻量审批的作者名单 |
| CODEOWNERS / branch protection | 指定路径必须由谁批准 / 主干分支的合入保护 |
| merge queue / merge train | 合入前把改动放到最新主干上重跑检查(GitHub / GitLab 的叫法) |
| feature flag(功能开关) | 不重新发版就能开关某个功能 |
| latest / stable channel | 先发的通道 / 晚一步跟进的稳定通道 |
| on-call | 轮值负责处理线上问题的人 |
| incident review(事故复盘) | 事故后分析原因;本文固定问"本该被哪一层拦住" |
| circuit breaker(熔断器) | 指标变坏时自动收紧审批的机制;文章承认还没有 |
| blast radius(影响范围) | 一个改动出错会波及多大范围 |
| eval | 一组带已知答案的题目,这里是过去引发事故的 PR |
| recall(召回) | 真 bug 被抓到的比例 |
| precision / noise(精确率 / 噪音) | 报出的意见里有多少是真问题 / 假问题 |
| rounds-to-pass(审查轮次) | 一个 PR 经过几轮审查和修复才通过 |
| convergence(收敛) | 审查和修复的循环能在有限轮内停下 |
| Swiss cheese model(瑞士奶酪模型) | 多层各有漏洞的防线叠起来,同时穿过所有层的问题很少 |
| dogfooding(内部先用) | 新功能先给自己公司的人用 |
| phased release(分阶段发布) | App Store 在 7 天内按比例推送自动更新,可暂停 |
| reconciliation(对账) | 比对两边记录是否一致,这里是苹果交易和数据库权益 |
| red-green(先红再绿) | TDD 里先看测试失败,再实现让它通过 |
参考链接
- 原文:https://claude.dev/blog/solving-code-review-at-anthropic/
- 原文 Markdown 版:https://claude.dev/blog/solving-code-review-at-anthropic.md
- Code Review for Claude Code:https://code.claude.com/docs/en/code-review
- 自动安全审查:https://support.claude.com/en/articles/11932705-automated-security-reviews-in-claude-code
- Claude Code 最佳实践:https://code.claude.com/docs/en/best-practices
- Redesigning source control:https://www.anthropic.com/engineering/redesigning-source-control
- Code Review 研究预览:https://claude.com/resources/articles/code-review
- 扩展 CI 与测试影响分析:https://claude.com/resources/articles/agentic-coding-is-straining-ci-heres-how-we-scaled-test-impact-analysis-at-anthropic
- Boris Cherny 的推文:https://x.com/bcherny/status/2007179861115511237
- Claude Tag:https://claude.com/product/tag
上手:在一个仓库上先跑 /code-review 和 /security-review,加一份 REVIEW.md,按 10.2 的第一批开始。